Bild-zu-Video vs. Text-zu-Video: Welches sollte man beim Geschichtenerzählen verwenden?
Text-zu-Video bietet das klarste Versprechen in der generativen Filmproduktion: Beschreibe eine Szene und erhalte einen dynamischen Clip. Bild-zu-Video fügt einen weiteren Schritt hinzu: Erstelle oder wähle ein Standbild und animiere es dann. Dieser zusätzliche Schritt mag sich langsamer anfühlen, gibt den Geschichtenerzählern aber oft mehr Kontrolle.
Beide Methoden haben keine absolute Vor- oder Nachteile. Die richtige Wahl hängt davon ab, welche Teile stabil bleiben müssen und welche Teile durch Generierung entdeckt werden können.
Wie Text-zu-Video tatsächlich funktioniert
Mit Text-zu-Video-Generierung definiert der Prompt das Subjekt, die Umgebung, die Aktion, die Kameraeinstellung, den Stil und oft auch den Ton. Das Modell entwirft gleichzeitig die anfängliche Komposition und die Bewegung.
Dies gilt für:
- Emotionen und Konzepte erkunden
- Umgebung ohne doppelte Zeichen
- Übergangs- oder Atmosphärenaufnahmen
- Überraschende visuelle Kreativität
- Objektive, die für präzises Design nicht wichtig sind
Schwächen sind außer Kontrolle geratene Kreativität. Wenn eine Geschichte von bestimmten Gesichtern, Kostümen, Requisiten oder Layouts abhängt, könnte bereits der erste Bildausschnitt falsch sein. Das Umschreiben von Aufforderungen kann eine völlig andere Komposition erzeugen, anstatt die ursprüngliche Absicht zu korrigieren.
Wie die Umwandlung von Bildern in Videos das Problem verändert
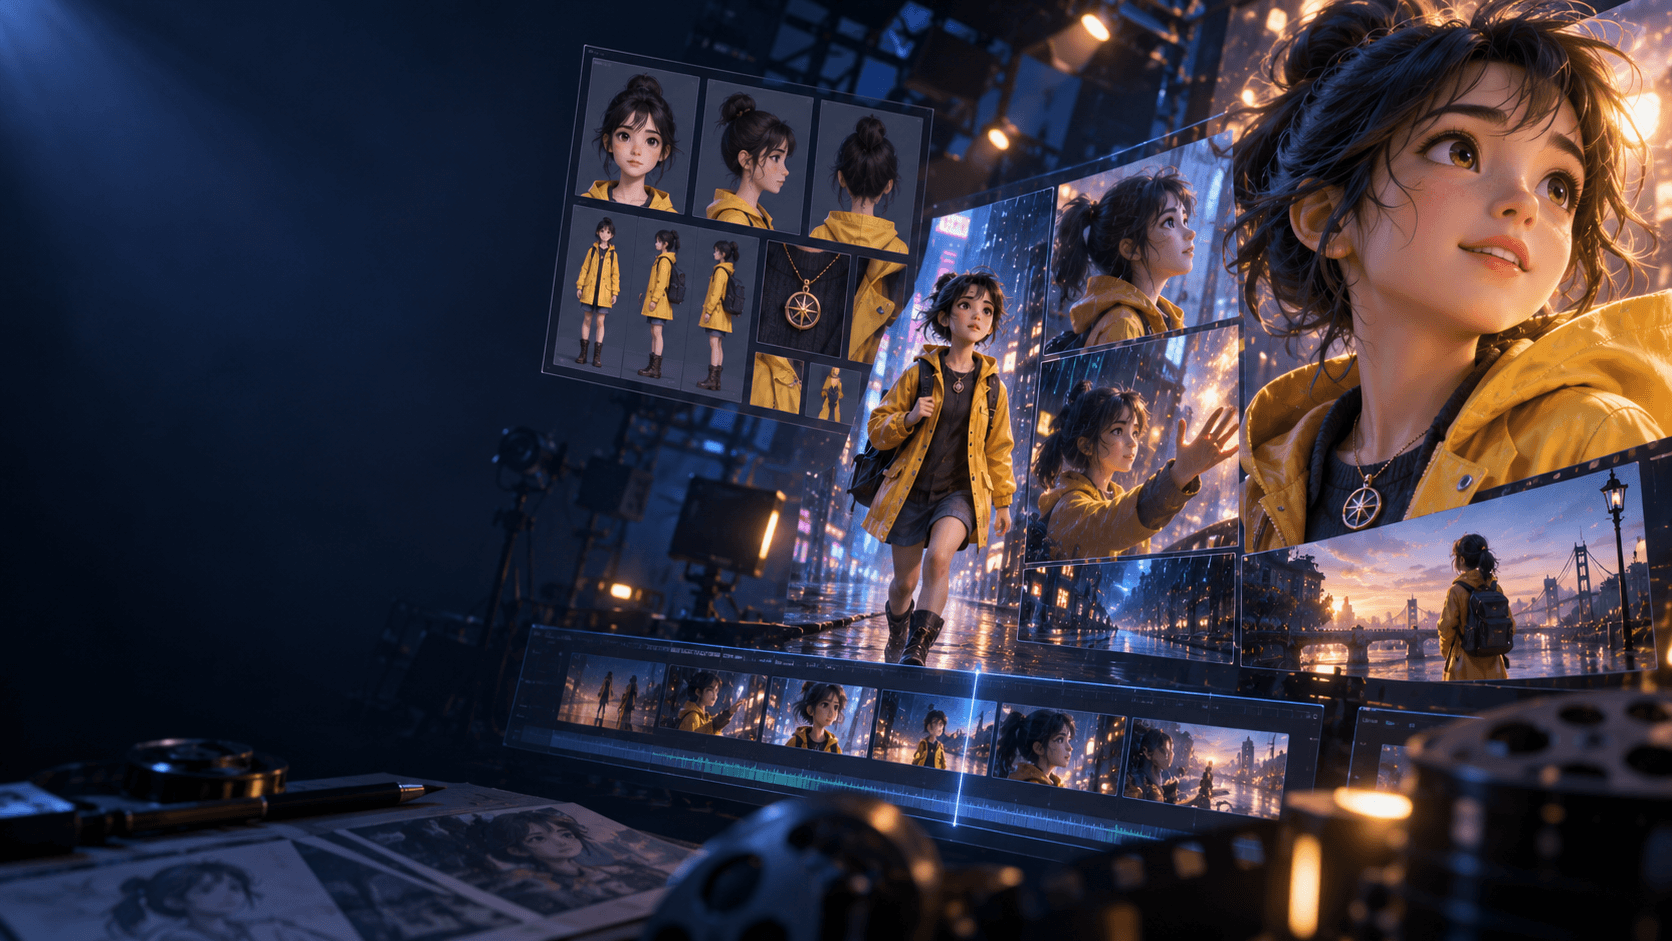
Die Erzeugung von Bild zu Video beginnt mit einem genehmigten visuellen Zustand. Das Modell konzentriert sich stärker auf die Bewegung zwischen den Einzelbildern. Dies macht es besonders wertvoll für wiederkehrende Charaktere, Produkte, stilisierte Kompositionen und präzise künstlerische Anleitung.
Gilt für:
- Charakter-Nahaufnahme
- Konsistenz zwischen Produkt und Kleidung
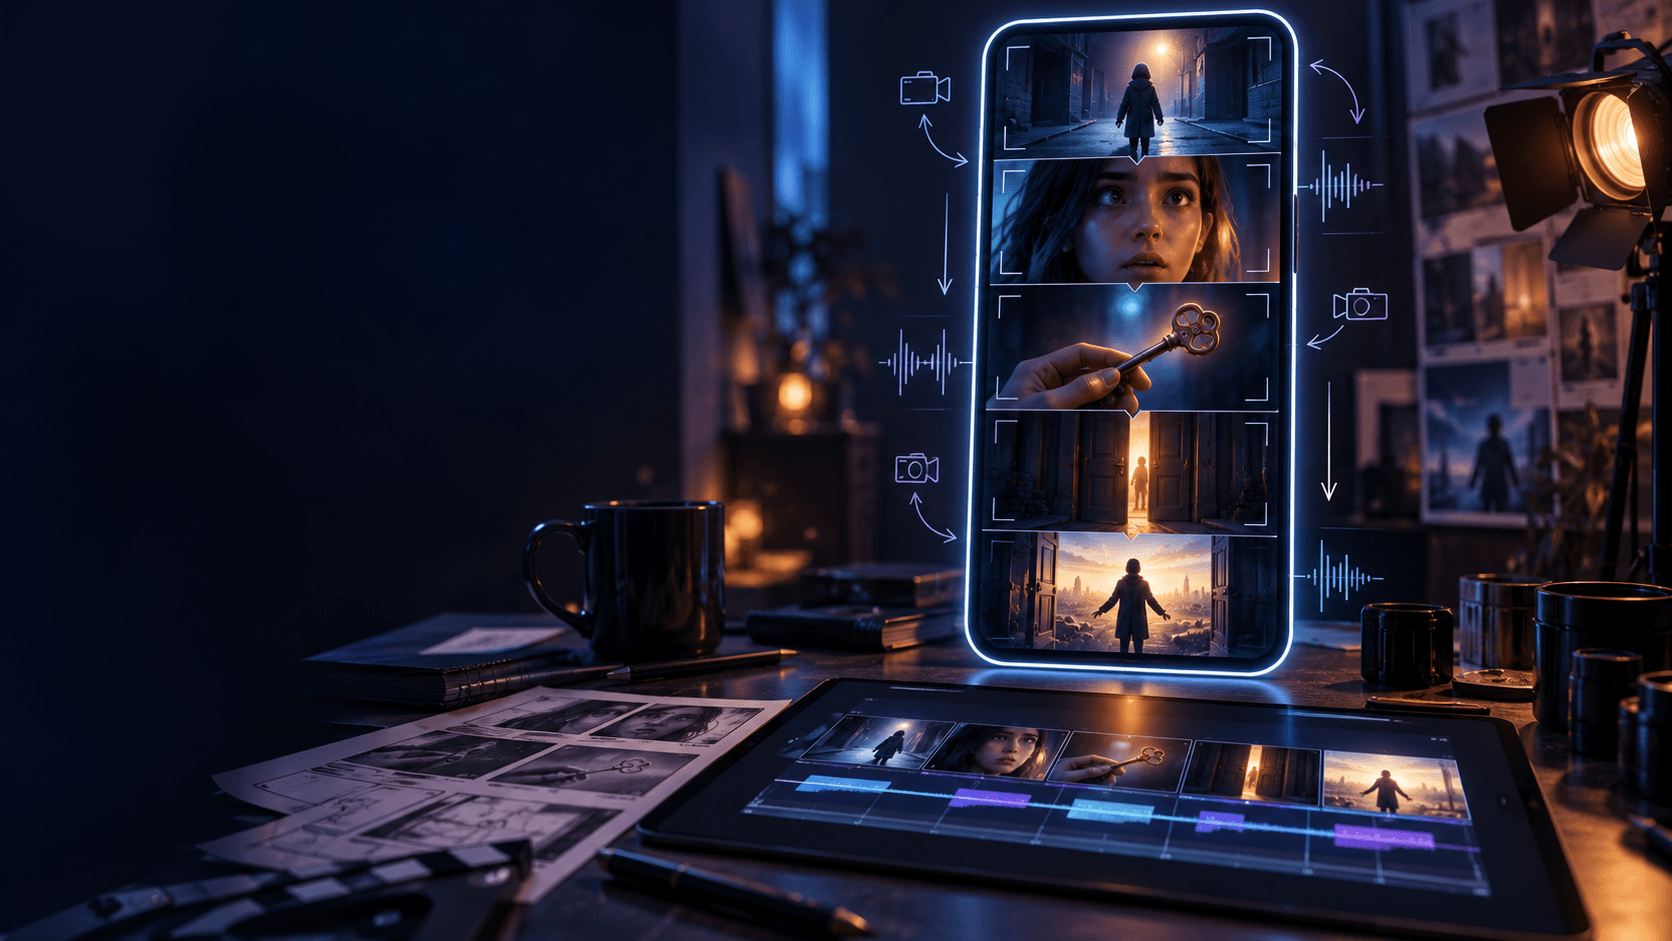
- Übereinstimmung mit der Storyboard-Komposition
- Behalten Sie die entworfene Position bei
- Auf einem bestimmten Frame beginnen oder enden
Der Nachteil ist, dass das Bild die Bewegung einschränken kann. Steife Posen, abgeschnittene Gliedmaßen oder physisch unnatürliche Kompositionen können zu schlechten Animationseffekten führen. Wenn sich die Kamera dreht, muss das Modell nicht angezeigte Informationen ableiten.
Vergleich der beiden Methoden basierend auf den Produktionsanforderungen
| Produktionsbedarf | Text-zu-Video | Bild-zu-Video | |---|---|---| | Schnelle Ideenfindung | Stark | Mittel | | Exakte Erstkombination | Schwach bis mittel | Stark | | Ständige Charaktere | Schwer vorherzusagen | In der Regel stärker | | Große Kamerarotation | Frei gestaltbar | Kann ungesehene Lücken aufdecken | | Kunstrichtungsstil | Abhängig von der Eingabeaufforderung | Mit dem Quellbild als Anker | | Einstellungszeit | Niedriger | Höher | | Ein visuelles Detail beheben | normalerweise schwierig | vor der Animation beheben |
Eine wichtige wirtschaftliche Erkenntnis ist, dass die Einrichtungszeit die Generierungszeit sparen kann. Ein sorgfältig geprüftes Bild kann zehn Videowiederholungen vermeiden.
Entdeckung mit Text-zu-Video
Wenn du noch nicht die beste Komposition gefunden hast, kann Text-zu-Video wie ein dynamisches Skizzenbuch wirken. Halte den Prompt auf eine visuelle Idee fokussiert und generiere einige wirklich unterschiedliche Richtungen, anstatt nur feine Variationen.
Sobald das Ergebnis einen starken kompositorischen Rahmen zeigt, extrahiere kreative Entscheidungen: niedriger Winkel, zentrierter Türrahmen, Silhouette im Nebel. Falls eine Verbindung mit anderen Aufnahmen nötig ist, rekonstruiere oder optimiere diese Kreativität zu einem stabilen statischen Bild.
Verwendung der Funktion "Bild in Video umwandeln" für Zusagen
Sobald Identität und Komposition genehmigt wurden, schützt die Funktion „Bild-zu-Video“ diese Investition. Bitte bereiten Sie das Quellbild im Ziel-Seitenverhältnis vor. Lassen Sie ausreichend Platz für Bewegung und vermeiden Sie das Beschneiden von Körperteilen, die sich möglicherweise bewegen müssen.
Verfassen Sie eine Eingabeaufforderung, die sich um die Veränderung (von Anfang bis Ende) dreht:
Die Laternenflamme flackert im Wind. Die Figur ballt die Fäuste und macht vorsichtig einen Schritt nach vorne. Die Handkamera schwenkt langsam, ohne umlaufende Aufnahme. Behalte die Form von Gesicht, Mantel und Laterne bei.
Verlangen Sie nicht, dass ein für Nahaufnahmen konzipiertes Standbild zu einer Ganzkörper-Laufszene wird. Bitte erstellen Sie einen geeigneteren Quellframe.
Hybride Workflows sind oft am leistungsfähigsten
Professionelles KI-Erzählen ist kein Loyalitätstest. Verwende Text-zu-Video, um Wolken, Menschenmengen, Atmosphäre oder unerwartete Übergänge darzustellen. Verwende Bild-zu-Video, um Hauptfiguren, Schlüsselrequisiten, Dialogaufnahmen und Kompositionen, die übereinstimmen müssen, zu präsentieren.
Du kannst mit Elser AI schnell statische Bilder durchsehen, einschließlich browserbasierter Bild-, Anime-, OC-, Storyboard- und Videoerstellung. Wenn sich ein Projekt zu einer Sequenz erweitert, kann ElserStudio Geschichten, genehmigte Welt-Assets, Kamerareferenzen, Kandidatenclips und Kompositionen auf einer Leinwand organisieren.
Die Grenzen sind praktisch: Mit Elser AI schnell Material erstellen und testen; wenn dieses Material mit Skript und Schnitt in Verbindung bleiben muss, verwenden Sie ElserStudio.
Auswahl nach Objektiv, nicht nach Projekt
Ein Film kann beide Methoden kombinieren. Die Kennzeichnung erfolgt anhand der stärksten Einschränkungen jeder Einstellung:
- Identitätskritisch: Verwendung von normativen Spiegelreferenzen
- Schlüssel zur Synthese: Verwenden Sie ein Storyboard oder einen Startframe
- Bewegungsrelevanz: Verwendung eines vereinfachten visuellen Testvideomodells
- Atmosphäre entscheidend: Text-zu-Video könnte bereits ausreichen
- Übergangs-Keyframes: Start- und Endframe berücksichtigen
Diese Art von Entscheidung auf der Einstellungsebene ist effizienter, als eine einzige Methode über die gesamte Serie hinweg zu erzwingen.
Überprüfen Sie den tatsächlich generierten Inhalt des Modells
Für Text-zu-Video: Überprüfen Sie die Designkohärenz, die Geografie der Szene und überflüssige Objekte. Für Bild-zu-Video: Überprüfen Sie Identitätsverschiebungen, Texturschwankungen, fiktive Rückansichten und unnatürliche Bewegungen.
In beiden Fällen wird die letzte Sekunde bewertet. Das verfügbare Ende bestimmt, ob der nächste Schnitt machbar ist. Auch der Ton sollte separat geprüft werden; ein visuell starkes Fragment kann unbrauchbare Dialoge oder Umgebungsgeräusche enthalten.
Häufig gestellte Fragen
Ist Bild-zu-Video besser geeignet, um die Konsistenz der Charaktere zu wahren?
In der Regel, weil das Bild Identität und Kleidung verankert. Das Ergebnis kann dennoch je nach Pose, Bewegung, Referenz und Modellverhalten variieren.
Ist Text-zu-Video schneller?
Es hat weniger Einstellungen, aber wenn das Aussehen präzise sein muss, sind möglicherweise mehr Wiederholungen erforderlich. Bitte bewerten Sie den gesamten Prozess der akzeptablen Aufnahme.
Kann ich Storyboard-Panels als Eingabe für Bild-zu-Video verwenden?
Ja, wenn das Panel sauber ist und einen vernünftigen Startframe darstellt. Grobe Storyboards sind hervorragende Planungswerkzeuge, müssen aber vor der Animation möglicherweise verfeinert werden.
Welche Methode eignet sich besser für Anime-Videos?
Bild-zu-Video hilft in der Regel, die Anime-Charaktere und die künstlerische Ausrichtung eines Designs zu bewahren. Text-zu-Video bleibt nützlich für Erkundungen und nicht wiederholte Aufnahmen.
Fazit
Text-zu-Video ist am stärksten, wenn man erkunden möchte. Bild-zu-Video ist am stärksten, wenn man Kontrolle benötigt. Ein durchdachtes Projekt nutzt beides und wählt dies Aufnahme für Aufnahme. Bestimme, was sich nicht ändern darf, gib die richtigen Ankerpunkte vor und bewerte das Ergebnis im Schnitt – nicht als isolierte Vorführung.