이미지를 비디오로 vs 텍스트를 비디오로: 스토리텔링할 때 어떤 것을 사용해야 할까요?
텍스트를 비디오로 변환은 생성형 영화 제작에서 가장 명확한 약속을 제공합니다: 장면을 설명하면 동적 클립을 얻을 수 있습니다. 이미지를 비디오로 변환하는 것은 한 단계를 더 추가합니다: 정적 화면을 생성하거나 선택한 다음 애니메이션화하는 것입니다. 이 추가 단계는 더 느리게 느껴질 수 있지만, 일반적으로 스토리 크리에이터에게 더 많은 제어권을 제공합니다.
두 가지 방법에는 절대적인 좋고 나쁨이 없습니다. 올바른 선택은 어떤 부분이 안정적으로 유지되어야 하고, 어떤 부분이 생성을 통해 발견될 수 있는지에 달려 있습니다.
텍스트를 비디오로 변환하는 실제 작동 원리
텍스트 기반 영상 생성에서 프롬프트는 주체, 환경, 동작, 촬영, 스타일을 정의하며, 일반적으로 소리도 포함합니다. 모델은 초기 구도와 움직임을 동시에 구상합니다.
이것은 다음에 적용됩니다:
- 감정과 개념 탐구
- 중복 문자가 없는 환경
- 전환 또는 분위기 샷
- 놀라운 시각적 창의성
- 정밀 설계에 중요하지 않은 렌즈
약점은 통제 불능의 창의성입니다. 이야기가 특정 얼굴, 의상, 소품 또는 구도에 의존한다면, 첫 프레임부터 이미 잘못되었을 수 있습니다. 프롬프트를 다시 작성하면 원래 의도를 수정하는 대신 완전히 다른 구도가 생성될 수 있습니다.
이미지-투-비디오가 문제를 어떻게 바꾸는가
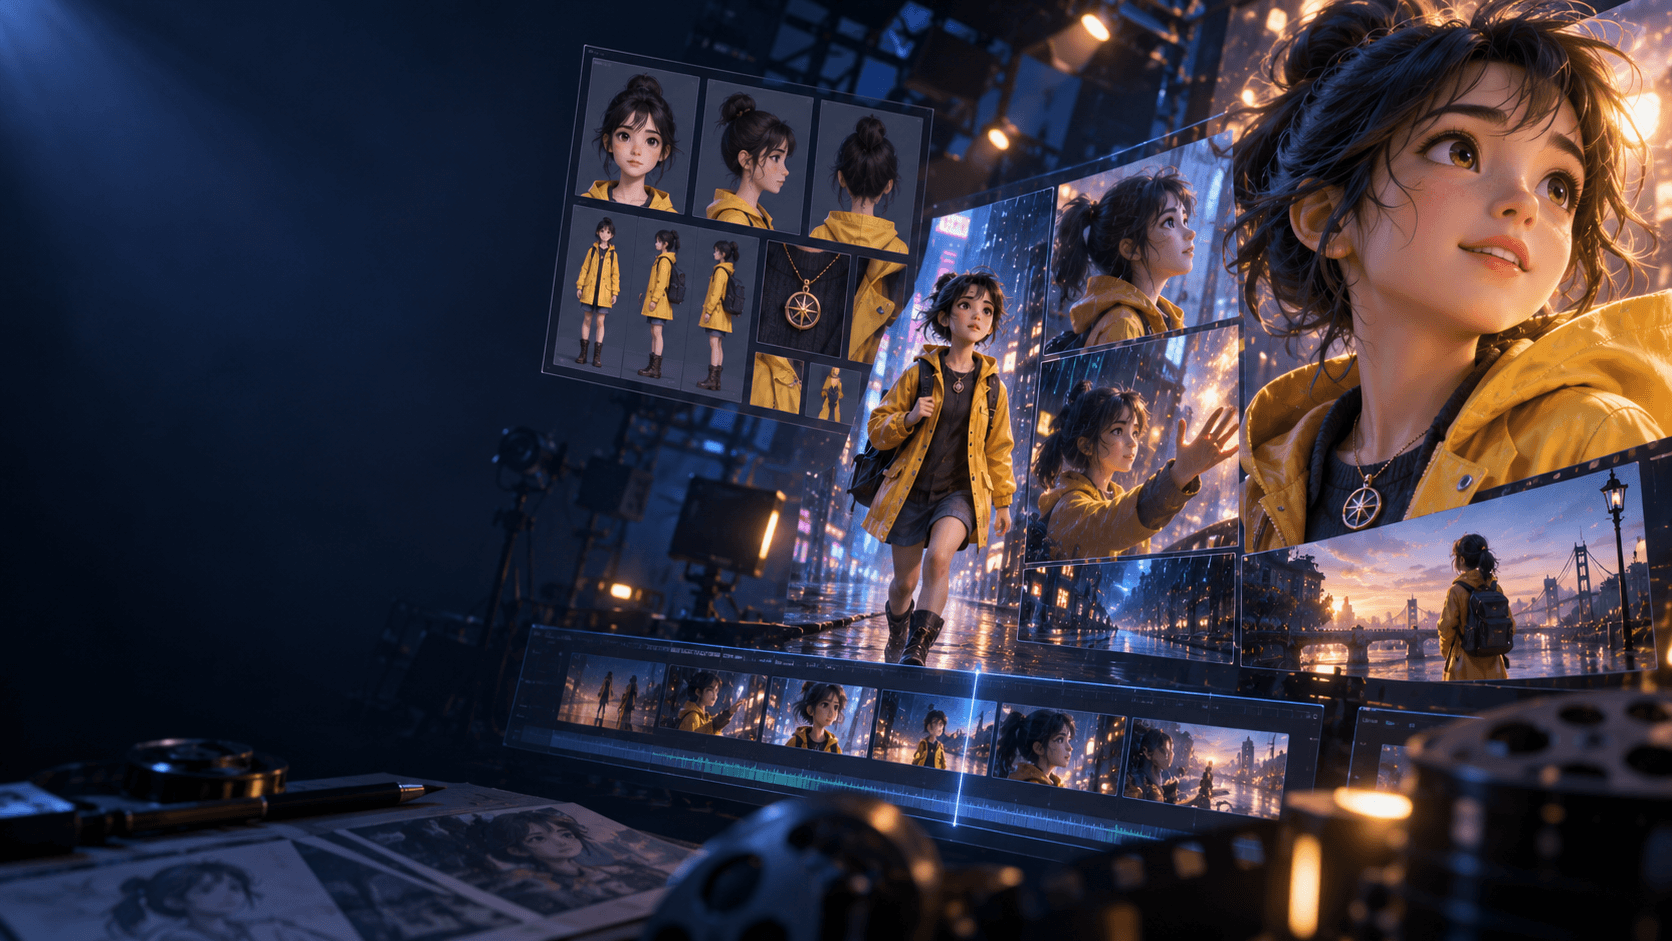
이미지에서 비디오로의 생성은 승인된 시각적 상태에서 시작됩니다. 모델은 프레임 간의 움직임에 더 중점을 둡니다. 이는 반복되는 캐릭터, 제품, 스타일화된 구성 및 정확한 아트 디렉션에 특히 유용합니다.
적용 대상:
- 캐릭터 클로즈업
- 제품과 의류의 일관성
- 스토리보드 구도 매칭
- 설계된 위치 유지
- 특정 프레임에서 시작 또는 종료
단점은 이미지가 움직임을 제한할 수 있다는 점입니다. 뻣뻣한 자세, 잘린 팔다리 또는 물리적으로 부자연스러운 구도는 애니메이션 효과를 떨어뜨릴 수 있습니다. 카메라가 회전할 때 모델은 표시되지 않은 정보를 추론해야 합니다.
생산 요구에 따라 두 가지 방법 비교
| 생산 요구 | 텍스트를 비디오로 | 이미지를 비디오로 | |---|---|---| | 빠른 구상 | 강함 | 중간 | | 정확한 최초 조합 | 약함에서 중간 | 강함 | | 상주 캐릭터 | 예측이 어려움 | 일반적으로 더 강함 | | 대규모 카메라 회전 | 자유롭게 창작 가능 | 보이지 않던 틈이 노출될 수 있음 | | 아트 디렉션 스타일 | 프롬프트 의존 | 소스 이미지 앵커 | | 설정 시간 | 낮음 | 높음 | | 시각적 세부 사항 수정 | 일반적으로 어려움 | 애니메이션 전에 수정 |
중요한 경제적 통찰은 설정 시간이 생성 시간을 절약할 수 있다는 것이다. 신중하게 검토된 이미지 하나가 열 번의 비디오 재시도를 피할 수 있다.
텍스트를 비디오로 변환하여 발견하기
아직 최적의 구도를 정하지 못했을 때, 텍스트-비디오 생성은 동적인 스케치북처럼 활용될 수 있습니다. 프롬프트를 하나의 시각적 아이디어에 집중시키고, 미세한 변형이 아닌 진정으로 다른 몇 가지 방향을 생성하세요.
결과가 강한 구도 프레임을 보여주면 창의적 결정을 추출한다: 로우 앵글, 중앙의 문틀, 안개 속 실루엣. 다른 장면과 연결해야 한다면 해당 창의성을 안정적인 정적 화면으로 재구성하거나 최적화한다.
이미지를 비디오로 변환 기능 사용에 대한 약속
신원과 구도가 심사를 통과하면, 이미지-투-비디오 기능이 이러한 투자를 보호합니다. 대상 가로세로 비율에 맞춰 원본 이미지를 준비하세요. 움직임을 위한 충분한 공간을 확보하고, 움직일 수 있는 신체 부위가 잘리지 않도록 주의하세요.
변화(시작부터 끝까지의 변화)를 중심으로 프롬프트를 작성하세요:
등불의 불꽃이 바람에 흔들린다. 캐릭터가 주먹을 꽉 쥐고 조심스럽게 한 걸음 앞으로 내딛는다. 핸드헬드 샷이 천천히 패닝하며, 주변을 돌지 않는다. 얼굴, 외투, 등불의 형태를 유지한다.
클로즈업용으로 설계된 정적인 화면이 전신 달리기 장면으로 바뀌기를 요구하지 마십시오. 더 적합한 소스 프레임을 만들어 주십시오.
혼합 워크플로우가 일반적으로 가장 강력합니다
전문적인 AI 스토리텔링은 충성도 테스트가 아닙니다. 텍스트를 비디오로 변환하여 구름, 군중을 표현하고 분위기를 조성하거나 예상치 못한 전환을 만듭니다. 이미지를 비디오로 변환하여 주인공, 주요 소품, 대화 장면 및 반드시 일치해야 하는 구도를 제시합니다.
Elser AI를 사용하여 정적 화면을 빠르게 탐색할 수 있습니다. 여기에는 브라우저 기반의 이미지, 애니메이션, OC, 스토리보드 및 비디오 제작이 포함됩니다. 프로젝트가 시퀀스로 확장되면 ElserStudio에서 스토리, 승인된 세계 자산, 샷 참조, 후보 클립 및 구성을 하나의 캔버스에 정리할 수 있습니다.
한계는 실제적입니다: Elser AI로 소재를 빠르게 제작하고 테스트하세요; 이러한 소재가 스크립트와 편집과 연관되어야 할 때는 ElserStudio를 사용하세요.
렌즈에 따라 선택하고, 프로젝트에 따라 선택하지 마세요
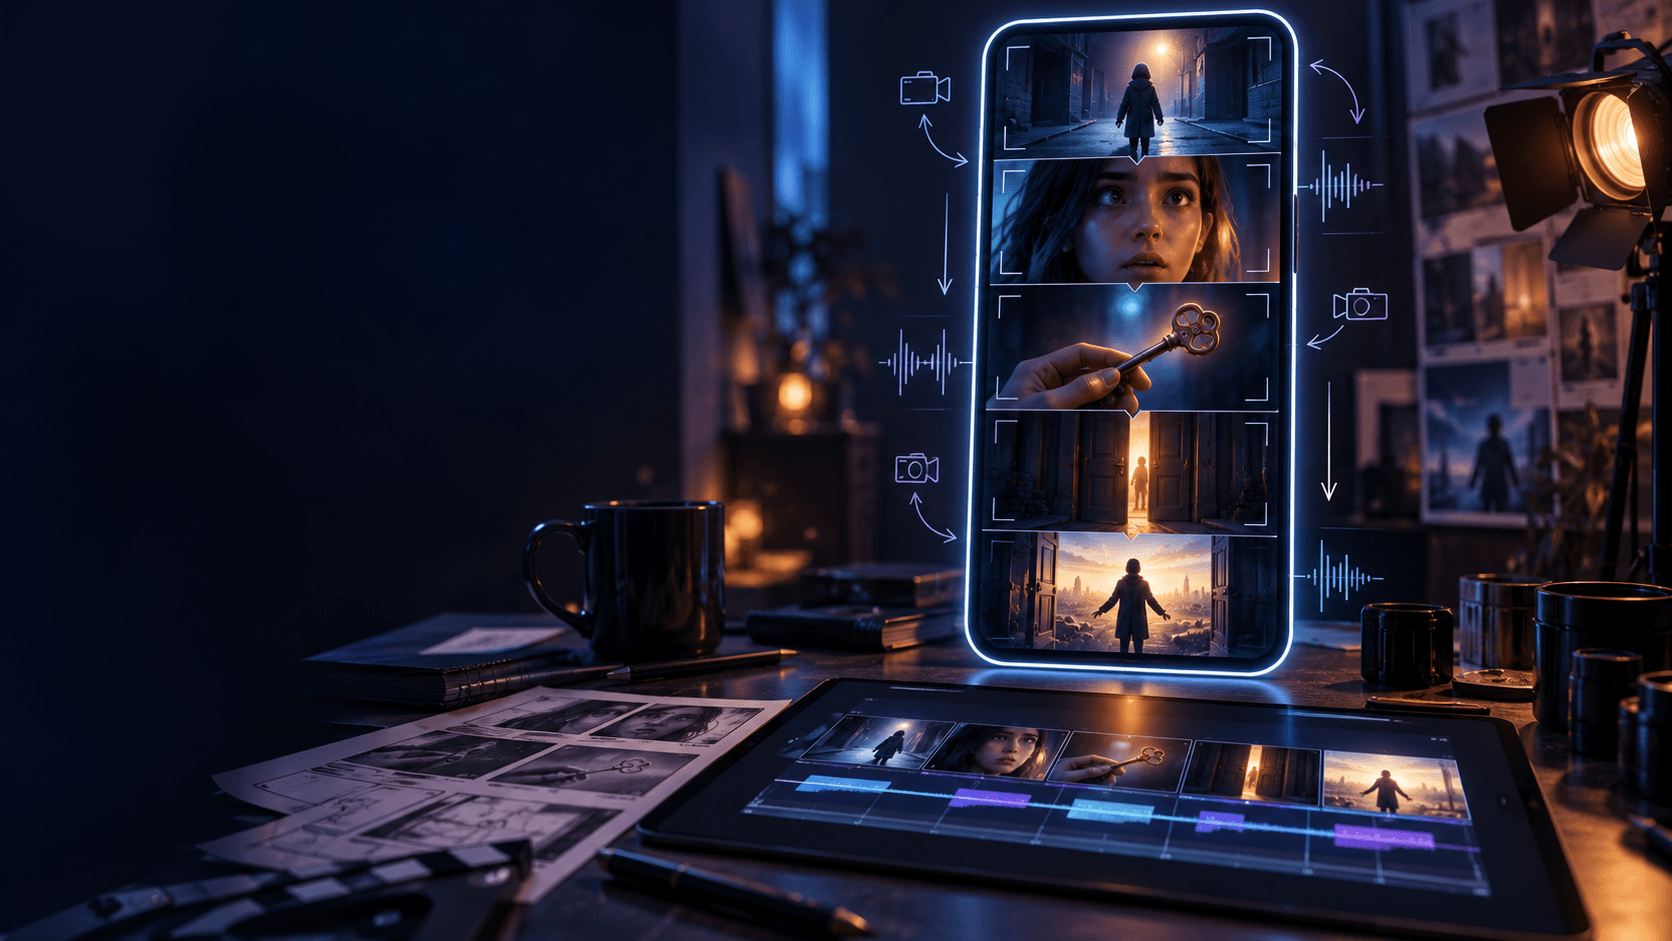
한 영화는 이 두 가지 방법을 혼합하여 사용할 수 있습니다. 각 장면의 가장 강력한 제약 조건에 따라 주석을 추가합니다:
- 신원 중요: 표준 이미지 참조 사용
- 합성 핵심: 스토리보드 또는 시작 프레임 사용
- 운동 핵심성: 단순화된 시각 테스트 비디오 모델 사용
- 분위기 중심형: 텍스트-비디오 생성이 충분할 수 있음
- 전환 키프레임: 시작 프레임과 종료 프레임 고려
이런 렌즈 레벨의 결정은 전체 시리즈에 하나의 방법을 강제하는 것보다 더 효율적이다.
审查模型实际生成的内容
텍스트-비디오 생성의 경우 디자인 일관성, 장면 지리 및 불필요한 객체를 확인합니다. 이미지-비디오 생성의 경우 신원 변동, 텍스처 변동, 가상의 후면 시점 및 부자연스러운 움직임을 확인합니다.
두 경우 모두 마지막 초를 평가해야 한다. 사용 가능한 엔딩이 다음 클립의 성립 여부를 결정한다. 소리 역시 별도로 검토해야 한다. 시각적으로 훌륭한 장면이라도 사용할 수 없는 대사나 주변음이 포함되어 있을 수 있다.
자주 묻는 질문
그림에서 비디오로 변환할 때 캐릭터 일관성을 유지하는 것이 더 적합한가요?
일반적으로 이미지가 신원과 의상을 고정하기 때문입니다. 결과는 자세, 동작, 참조 및 모델 행동에 따라 여전히 달라질 수 있습니다.
텍스트를 비디오로 변환하는 것이 더 빠른가요?
설정이 더 적지만, 외관이 정확해야 할 때는 더 많은 재시도가 필요할 수 있습니다. 전체적으로 허용 가능한 렌즈 과정을 평가해 주세요.
스토리보드 패널을 이미지-투-비디오 입력으로 사용할 수 있나요?
네, 패널이 깨끗하고 합리적인 시작 프레임을 나타낸다면 그렇습니다. 대략적인 스토리보드는 훌륭한 계획 도구이지만, 애니메이션 제작 전에 세부 조정이 필요할 수 있습니다.
어떤 방법이 애니메이션 비디오에 더 적합할까요?
이미지-투-비디오는 일반적으로 디자인의 애니메이션 캐릭터와 아트 방향을 보존하는 데 도움이 됩니다. 텍스트-투-비디오는 탐색 및 비반복적인 장면에 여전히 유용합니다.
결론
텍스트-투-비디오는 탐색이 필요할 때 가장 강력합니다. 이미지-투-비디오는 제어가 필요할 때 가장 강력합니다. 신중하게 설계된 프로젝트는 이 둘을 모두 사용하여 샷별로 선택합니다. 변경할 수 없는 것이 무엇인지 결정하고, 올바른 앵커를 제공하며, 클립에서 결과를 판단하세요—고립된 데모가 아니라.